缘起
手边有一份几百页的行业文档,找一个数字翻了二十分钟没翻到,最后是同事一句「好像在第三章后面」解决的。那会儿正好在玩向量检索,就拿它试了一次:把文档切块灌进去,问一句,它把那句话连同出处一起还给我。
这个系统就是那次试验的正式版。
背景
企业里的文档其实不缺,缺的是「问得出来」:格式杂(txt、md、pdf、docx 混着来),同一件事在制度文件、会议纪要和群公告里各有一版且互相矛盾,新人和跨部门的人不知道该问谁,关键的人一离职知识就跟着走。纯关键词搜索解决不了表述不一致的问题,而直接让大模型回答又会编。所以要的是检索增强这条链路:解析入库、切块与向量化、命中后带原文出处回答,答不上来就明说没有,而不是猜一个。
方案
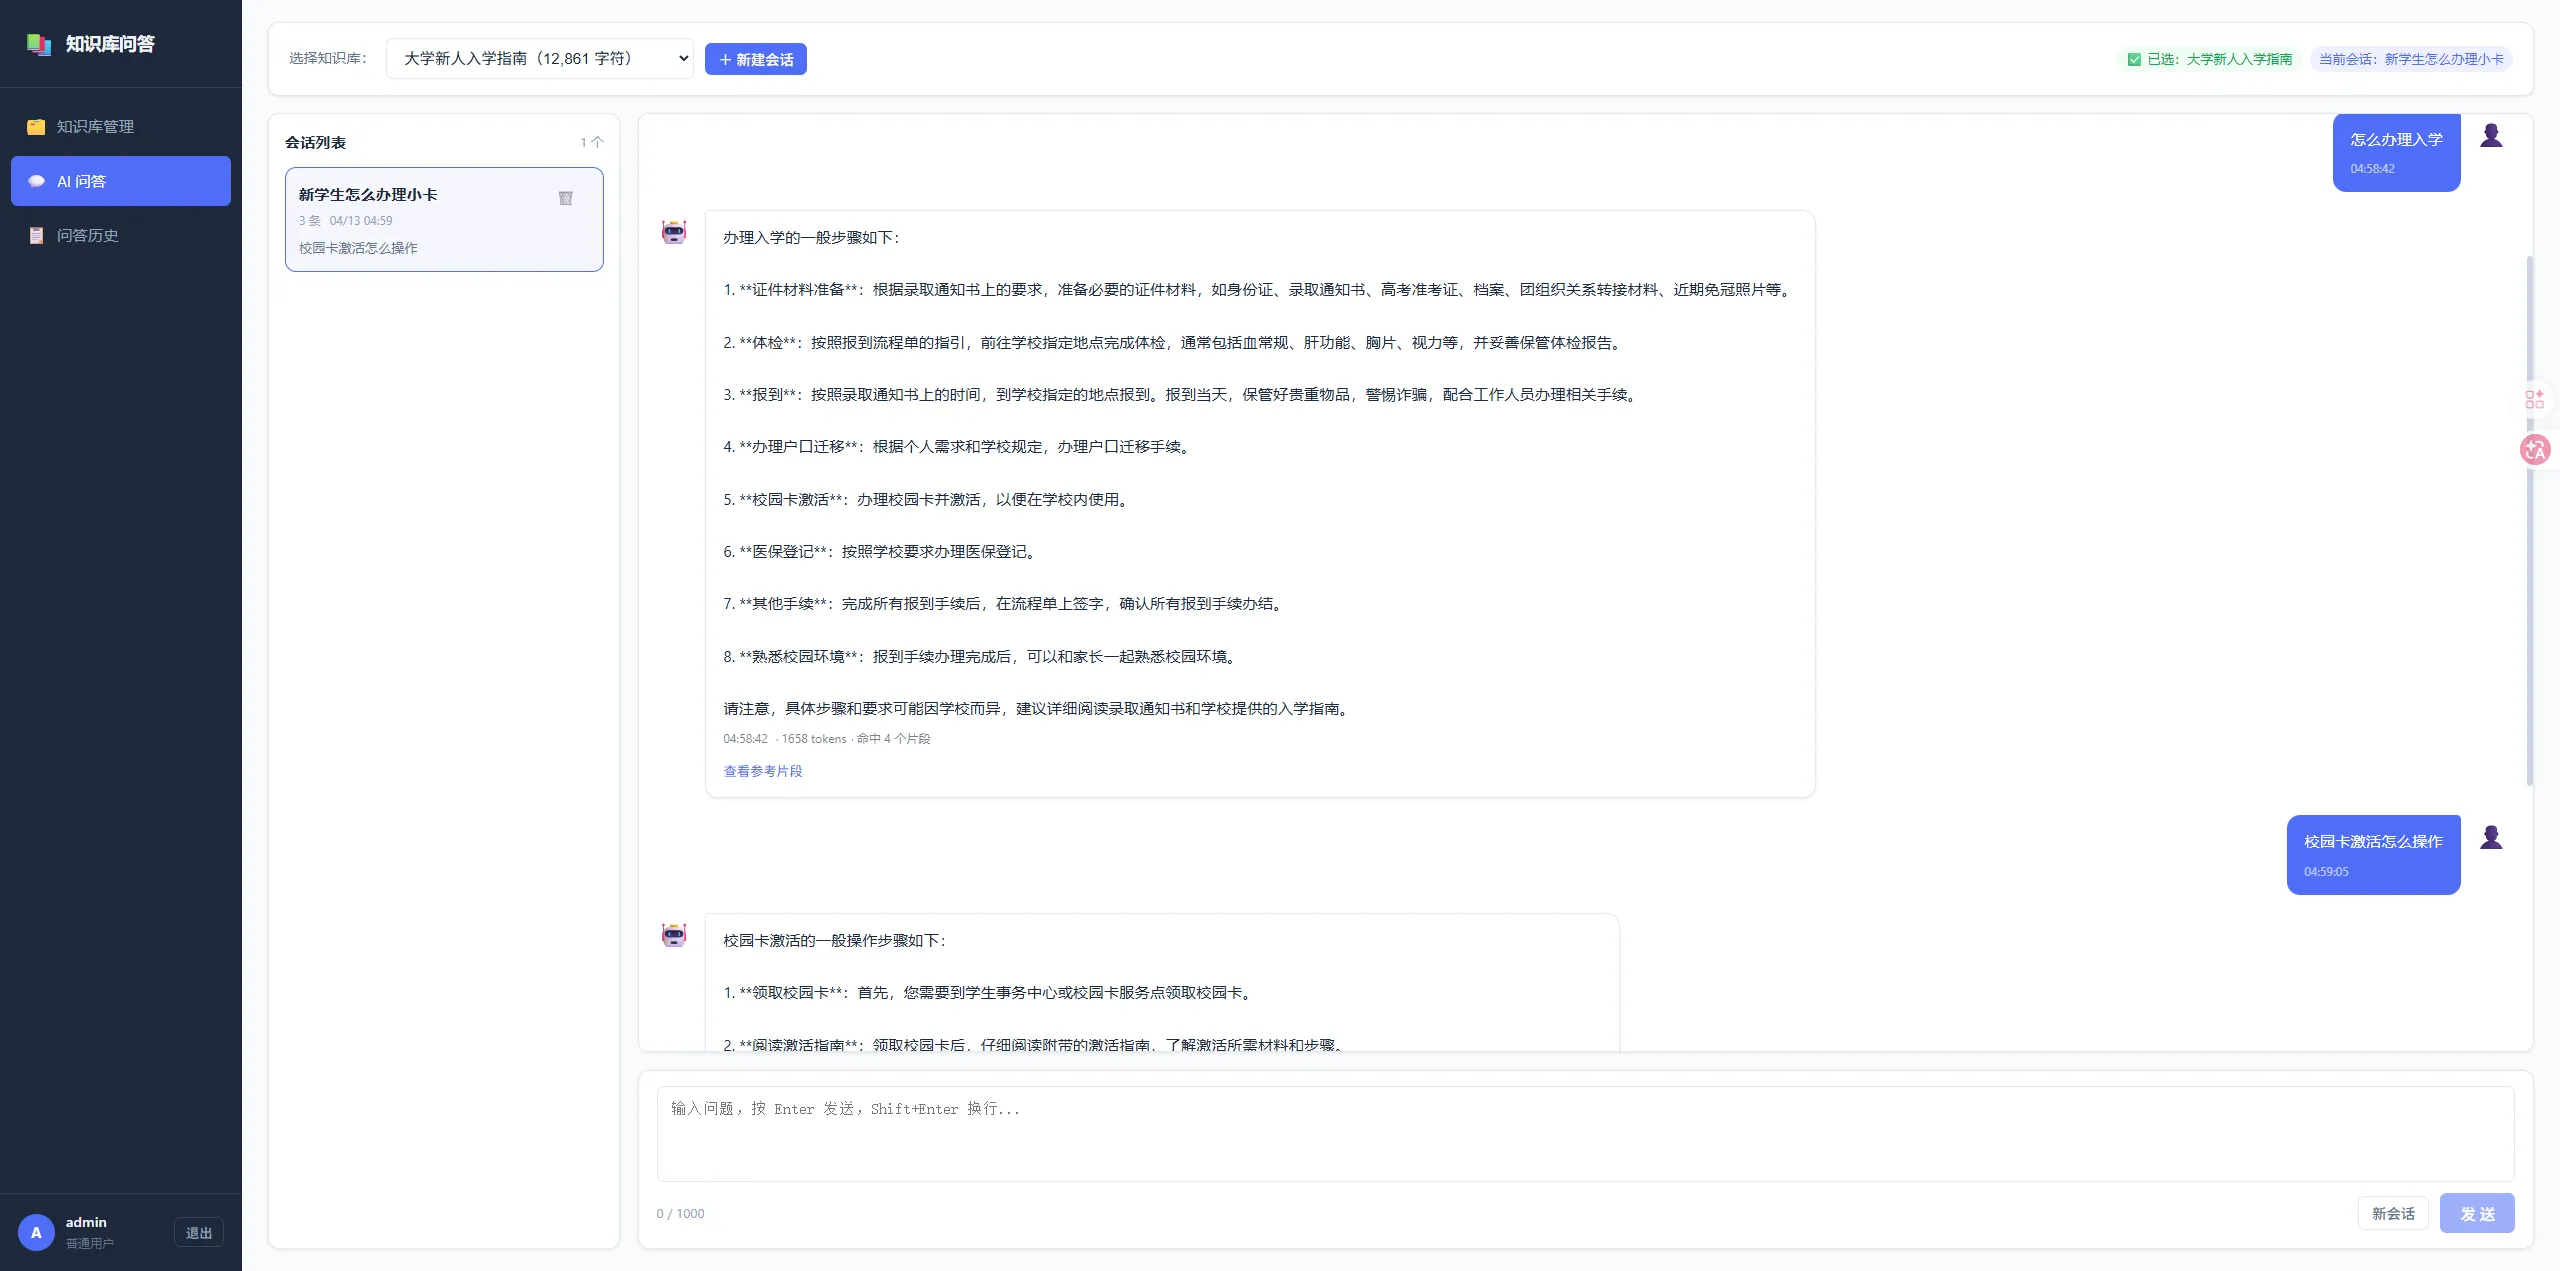
构建了支持多种文档格式的 RAG 问答系统:
- 文档上传:支持 .txt、.md、.pdf、.docx 格式
- RAG 流水线:文本分块 → 向量嵌入 → 向量检索 → 约束生成
- 多轮对话:会话管理和历史恢复,支持上下文理解
- 流式输出:SSE 流式响应,支持中途取消
- 多模型支持:智谱 AI、字节豆包、阿里通义、MiniMax,以及任意 OpenAI 兼容 API
- 动态切换:运行时动态切换模型,无需重启
技术架构
| 模块 | 技术选型 |
|---|---|
| 前端 | Vue3 + Vite + Pinia + Vue Router + Axios |
| 后端 | Python + Flask + Flask-SQLAlchemy + Flask-JWT-Extended |
| 数据库 | SQLite + ChromaDB(向量库) |
| AI | 多家国产大模型 + OpenAI 兼容接口 |
支持 Docker Compose 一键部署,配置从旧格式自动迁移到数据库存储。
成果
为企业提供了一套开箱即用的知识库问答解决方案。多模型支持让用户可以选择性价比最优的 AI 服务,流式输出提升了交互体验。