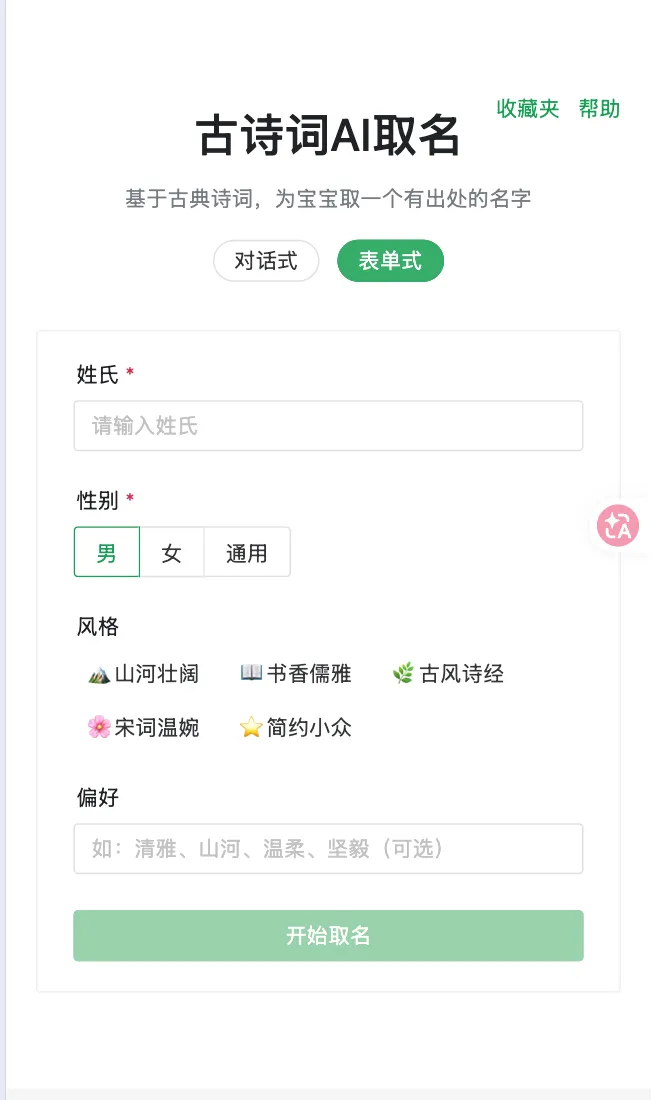
缘起
家里添了孩子,全家群里飘着几十个候选名,一半是短视频里抄的,一半是找人算的。我想自己从诗里翻一个,发现手头的电子文本根本搜不动:只有全文,没有按意象整理,人只能一句一句往下划。
那晚第一个脚本只做一件事——把「这个名字出自哪一句」和那句的意象对上。后来它长成了一个工具。
背景
取名这件事的难处不在字数,在约束同时存在:要有出处,出处要读得通,读音不能和姓氏打架,字形别太生僻,家里长辈还往往另有一套五行上的要求。纯文学检索只管前一半,纯命理工具只管后一半,两边凑到一起时又容易变成随机拼字。要做的是把这两组约束放进同一次生成里,并且每个候选都能点开看到它来自哪首诗、哪一句。
方案
名字的产出是一条流水线,从出生时辰走到候选项:
- 命理分析:按出生日期排八字四柱,算五行旺衰与喜用神,支持农历、公历双模式
- 两种方式找诗:用户给的是「清雅一点」这种模糊偏好时,系统按意境去语料里找相近的诗句;给的是「名字里要有某个字」这种硬要求时,就逐字去原文里匹配。两路结果合并排序,既听得懂意境,也不漏掉指定字
- 来源均衡:唐诗的数量远超其他朝代,直接按相关度取前几名会让候选几乎全是唐诗。系统按诗经、楚辞、唐诗、宋词分别给配额,保证来源不偏
- 取名生成:把候选诗句、五行宜忌、生肖规则、姓氏的读音特点组装起来,交给大模型产出候选名
- 质量过滤:五道关卡依次过——五格数理吉凶 → 禁用字与谐音 → 生僻字 → 读音是否顺口 → 五行是否相合,最后再综合排序
同一条流水线对外有三个入口:H5 网页、原生微信小程序、公众号关键词机器人。三者共用后端与配额体系——邀请码、微信登录、每日免费额度、关注公众号赠额度,都在同一处记账。
技术架构
| 模块 | 技术选型 |
|---|---|
| 后端 | Python + FastAPI |
| 前端 | Vue3(H5)+ 原生微信小程序 |
| 运营后台 | Go + Gin(另起进程,直接读同一批 SQLite 文件),管理端独立 Vue3 工程 |
| 检索 | FAISS(IndexScalarQuantizer + 8-bit 量化,MMAP 按需加载)+ SQLite FTS5,RRF 加权融合 |
| 生成 | 智谱 Embedding-3(向量)+ DeepSeek-V4 Flash(LLM),SSE 流式输出 |
| 命理与字库 | sxtwl 排八字、康熙字典笔画与字义、pypinyin 音律分析 |
| 数据 | 诗经、楚辞、全唐诗、宋词等古籍语料,约 38 万句 |
| 部署 | Docker Compose + Nginx 反向代理 |
系统分七层:客户端(H5 / 小程序)→ Nginx → FastAPI 应用层 → 中间件链 → 核心服务(八字、检索、生成、过滤排序)→ 数据存储(SQLite + FAISS)→ 外部模型服务。中间件链是五道:反爬签名、邀请码校验、IP 限流、免费额度、微信内容安全校验,规则改动不碰业务代码。
有三处工程细节值得单独说。一是检索的双路融合:纯语义检索擅长找"意境相近"但抓不住"必须含某个字"的硬约束,纯全文检索又读不懂"清雅山河"这样的抽象偏好,所以两路并行再用 RRF 加权合并,权重还能按场景调整。二是排序权重:音律 × 0.4 + 五格 × 0.3 + 出处 × 0.2 + 五行 × 0.1,四个维度可独立调节。三是运营后台换了语言:管理端的邀请码、命名规则、功能开关、统计与审计日志原先是 Python 后端的几个接口,后来抽成独立的 Go 服务——它不复制数据,直接读同一批 SQLite 文件,靠 WAL 模式保证跨语言读写安全。这样管理端的重启和 C 端请求互不影响。
成果
一次取名请求就能拿到五组名字,每组都带着原句、作者、朝代、单字释义和音律说明;不满意可以换一批,不必重新描述一遍需求。「有出处」这件事是结构上保证的——名字只能从检索到的真实诗句里来,模型不负责编造引文。
上线以来累计生成已达千次量级,单次成本在几分钱,从点下按钮到看到候选名只需几秒——比找人起名或自己翻书都快,成本低到可以忽略。
体验
H5 版在线可用:古诗词智能取名系统
微信小程序「文间拾字」:扫码或微信搜索体验,也可关注公众号获取取名灵感。
扫码体验小程序
关注公众号