本文素材全部来自一个真实项目:ecom-detail-ai——上传 1 张商品图,约 10 分钟得到一整套带真实感光影渲染的淘宝详情页。项目 2026-09-12 起步,到本文写作时刚满一个月,M1-M4 里程碑已全部完成。文中所有数据、版本记录、决策原文均为生产仓库实录。
一、AI 时代最大的悖论:代码变便宜了,"想清楚"变贵了
2026 年做一个 AI 应用,技术门槛已经低到离谱:
- 模型?国产 API 全部兼容 OpenAI 协议,换个 base_url 就能切;
- 代码?AI 编码工具一小时能给你撸出一个完整脚手架;
- Demo?一个周末能搭三个。
但打开任何一个 AI 产品社区,你会看到另一番景象:Demo 满天飞,能用的产品很少。大量项目死在同一个位置——从"需求"到"落地"之间的那条沟:
- 需求没拍板就动手,做到一半发现方向错了;
- 模型选型拍脑袋,上线才发现成本结构根本不成立;
- 关键决策不留痕,三个月后没人说得清当时为什么这么设计,重构时反复翻烧饼;
- 实施靠感觉,没有"问题在哪、改哪里、怎么验证"的闭环;
- 最要命的:文档写完就束之高阁,代码和文档各跑各的。
这篇不讲具体某个技术点,讲一条我们用一个月时间、从一句产品构想到跑通全链路的方法论。概括成一句话:
文档驱动开发,实测修订文档。
需求、选型、决策、实施、验收,每一步都先落成文档;每一次实测得到的结论,回头修订文档。文档不是汇报材料,是开发的"单一真相源"和"驾驶仪表"。
下面按实战顺序拆开讲。为了照顾不了解案例背景的读者,第二节先把项目交代清楚,后面所有举例都基于它。
二、先交代案例:这个项目是什么
2.1 一句话与核心链路
ecom-detail-ai:一个 Wails v2(Go + Vue3)桌面应用,面向淘宝/天猫中小卖家——上传 1 张商品图,约 10 分钟拿到一整套详情页(主图 + 长图切片 + 文案),全程不用选品类、不用选风格。替代的是"外包 300-1500 元/套、3-7 天交付"的传统做法。
它的核心是一条全自动 Agent 流水线:
图 1:全自动 Agent 流水线。左列自上而下是预处理与规划,右列自下而上是生成与交付;红色回环是自检不达标时的自动重渲染。
四个 LLM/视觉服务商分工协作,用户自带密钥(BYOK),单套 API 成本约 1-3 元。实测单套(5 图)8 分 27 秒。
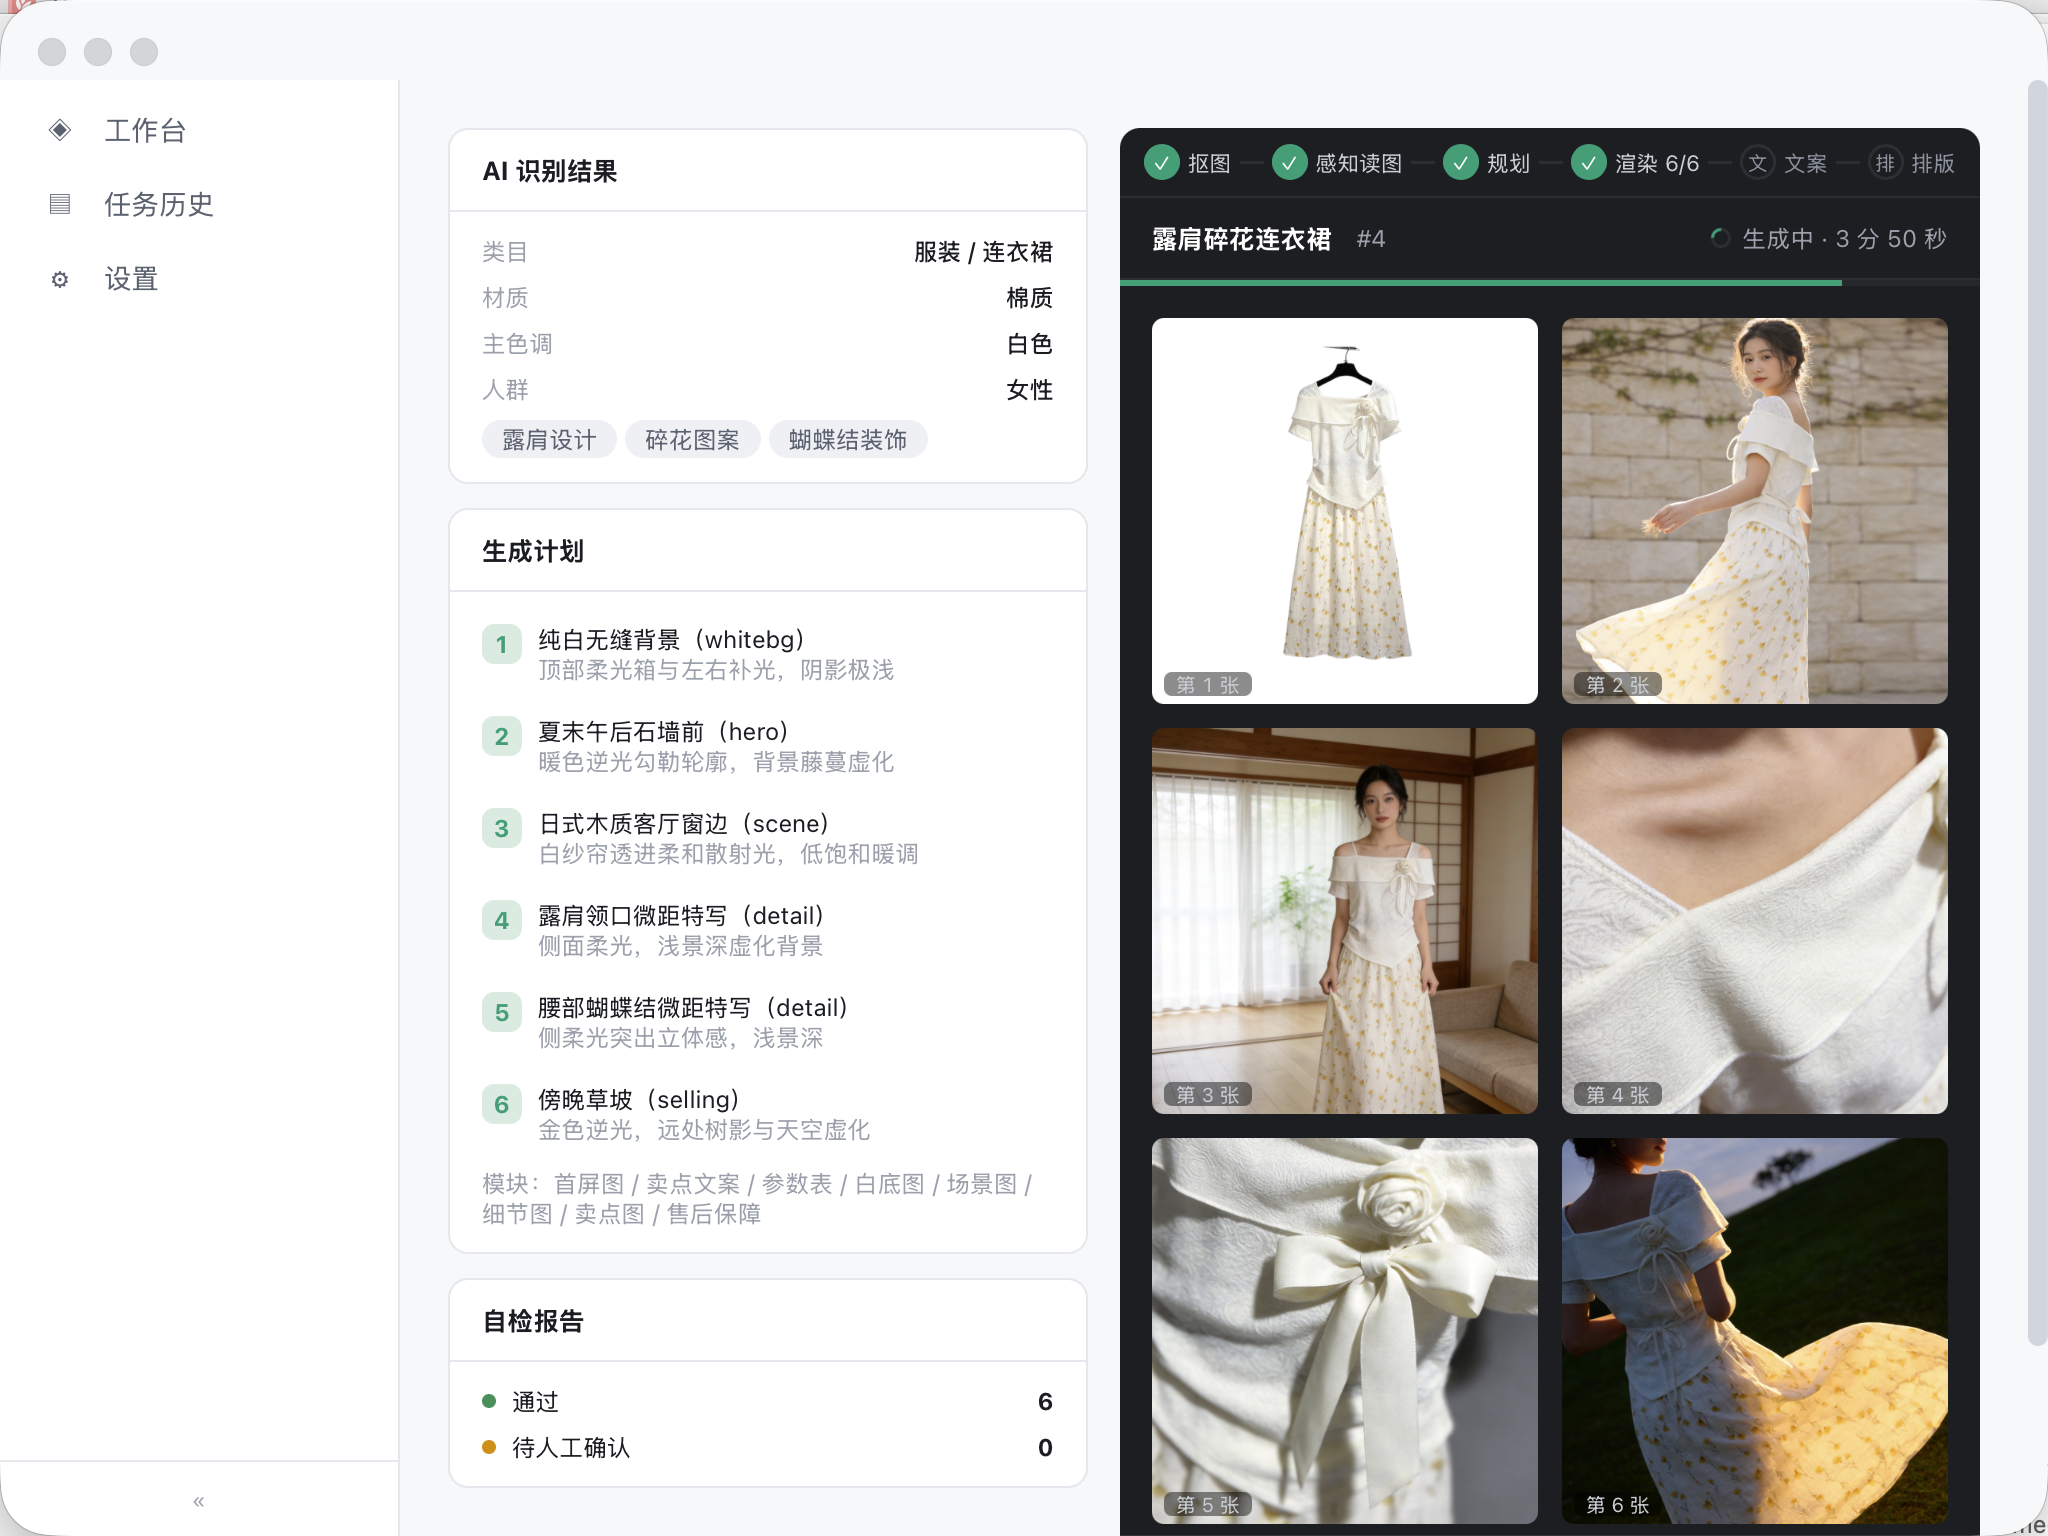
图 2:生成过程实录。左侧是 AI 识别结果与自主规划(本任务规划了 6 张图),右侧是渲染出图墙,顶部是流水线步骤进度,左下角是自检报告。
2.2 成品长什么样
一次真实任务(任务 #4,露肩碎花连衣裙)的导出产物:

图 3:750px 详情长图。首屏、卖点、参数、场景、售后等模块由 Agent 自主规划,排版合成本机完成。 (原图 750×5586 过长,此处限高展示,点开看完整长图 ↗)
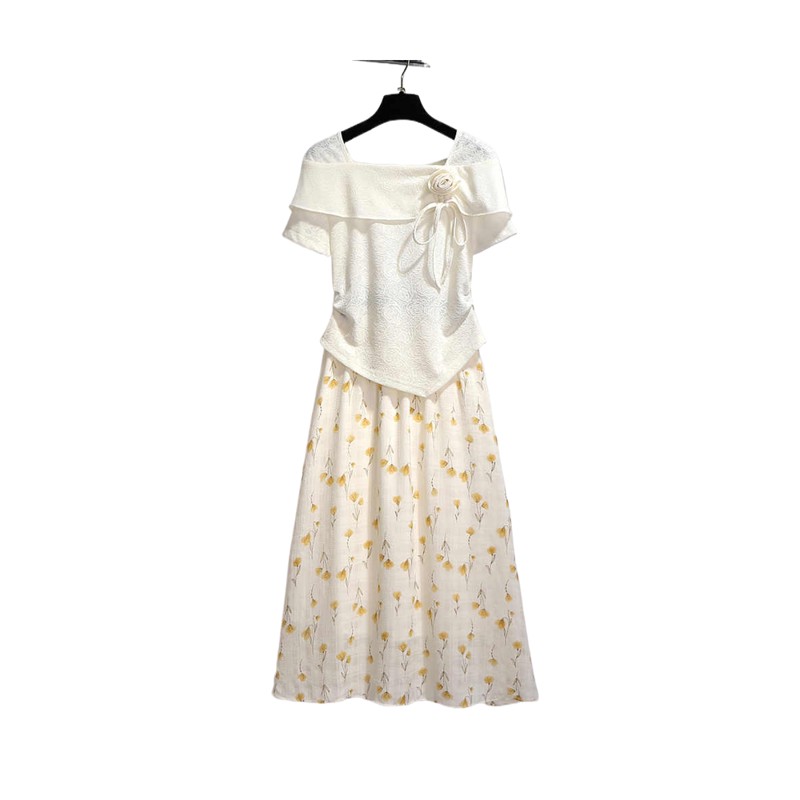
图 4:同一任务的主图包产物之一——800×800 白底图。淘宝规格要求 5 张主图里至少有一张纯白背景,这张由阿里云商品分割直接输出,不经过生成模型重绘。
2.3 四个关键事实
先记住这四个事实,后面的例子都挂在它们上面:
| 事实 | 内容 |
|---|---|
| ① 多模型协作 | 四家服务商四个岗位:智谱(读图+自检)、DeepSeek(规划+文案)、火山方舟(出图)、阿里云(抠图) |
| ② BYOK 模式 | 用户自带模型密钥,商品图只发到用户自己账户下的模型服务,产品方不经手不存储;每个任务的消耗金额明示给用户 |
| ③ 成本敏感 | 单套 API 成本 1-3 元,其中图像生成占 95% 以上——成本结构直接决定商业模式 |
| ④ 桌面客户端 | Wails(Go + Vue3),排版合成本机完成,批量任务走本地队列调度 |
2.4 术语卡(后文不再解释)
| 术语 | 一句话解释 |
|---|---|
| 详情页 | 淘宝商品页里那套决定转化的长图 + 图文组合 |
| 主图 / 白底图 | 商品列表页 800×800 方图,平台强制至少一张纯白背景 |
| 切片 | 长图按平台高度限制切成多张上传 |
| BYOK | Bring Your Own Key,用户自带模型密钥,费用走自己账户 |
| 模型位 | 流水线里某个环节对模型的"岗位",一个岗位一个选型 |
| VLM | 视觉语言模型,能"看图"的大模型 |
| 盲测 | 同一商品图喂给多个候选模型,人工对比选优 |
| 限流(RPM) | 模型 API 的调用速率配额,超了返回 429 |
2.5 为什么拿它当案例
三个原因:
- 链路完整:从一句产品构想到 M1-M4 里程碑跑完,每个阶段都有文档产物,是"需求落地方法论"的完整观察样本;
- AI 原生成分高:概率性依赖(模型输出不稳定)、多模型协作、成本敏感、需要自检闭环——传统软件的坑它一个不少,还多一层"依赖是租来的";
- 坑都落在文档里:盲测反转、限流约束、联调数据全部有记录——这正是方法论最好的验证材料。
三、第一步:PRD 是"拍板记录",不是"需求散文"
先看一个反面样本:大多数项目的 PRD 是一篇散文——背景、目标、功能列表,写完评审完就躺进硬盘,直到项目结束没人再打开。
我们的做法:PRD 是一份带修订记录的活文档,每个版本解决一类问题。看它的版本演变:
| 版本 | 日期 | 这个版本在记什么 |
|---|---|---|
| v0.9 | 09-12 | 需求探索:8 个模块全景 + 5 个待拍板问题(Q1-Q5) |
| v1.0 | 09-12 | Q1-Q5 全部拍板,升级为正式 PRD;补业界对标、平台规格、FR 编号与优先级 |
| v1.1 | 09-12 | 内部评审修订:修掉隐私口径矛盾、AI 标识合规、TaskStep 粒度等一串问题 |
| v1.3 | 09-12 | 真实 key 全流程联调通过:联调数据、踩坑、结论回写(第八节细讲) |
| v1.5 | 09-13 | 盲测结果导致选型反转:渲染主选更换(第四节细讲) |
| v1.7 | 09-13 | 平台水印可控性 + 标识分层的实测结论 |
注意 v1.3、v1.5、v1.7 的特殊性:它们都不是"需求变更",而是实测结论倒逼文档修订。PRD 在这里不是立项时写一次的石碑,而是跟着项目一起生长的账本。
3.1 三个可以直接抄走的写法
第一,用户故事用标准三段式,一个故事一个验收点。 "批量生成"功能(一次导入 100 个 SKU 挂机跑完,补的是稿定 CSV 批量套版的能力缺口)的需求是这么写的:
As a 新注册低 RPM 配额的卖家,I want 批量任务按全局并发上限(默认 1,可配 1-3)排队逐个执行,so that 不会因为多任务并行撞 API 限流导致整批失败。
一句话里包含:角色、动作、可量化的参数(并发 1-3)、要防的风险(限流)。评审时哪个参数有问题,当场就能吵清楚。
第二,"明确不做/边界"比"要做什么"更重要。 同一份批量 PRD 里专门有一节:
- 不动渲染管线内部:感知/规划/渲染/文案/排版各环节零改动,批处理只是调度层;
- 零新增依赖:CSV 解析用标准库
encoding/csv,不引 Excel 转码库; - 不做批量专属管理页:复用现有任务列表;
- 留 P2:夜间定时批跑、断点续跑、Excel 直接解析。
这一节是 MVP 的护栏。AI 编码时代"顺手多做一个功能"的边际成本极低,不做清单是防止范围失控的唯一物理阻断——和上一篇讲的架构护栏一个道理:约定必须变成某种形式的"断言"。
第三,待确认问题单独成节,允许带着问题上会。 Q1-Q6 每个问题给一个"建议答案 + 理由",评审的工作从"讨论"降级为"确认或否决建议"。小团队这个写法能把评审会从两小时压到二十分钟。
四、第二步:选型先于编码,且必须"拆位 + 实测"
AI 应用和传统软件最大的不同:你的核心能力是租来的。租什么、怎么租、租金多少,直接决定产品成不成立。所以我们的顺序是:产品构想 → PRD 拍板 → 选型验证 → 才写第一行业务代码。
4.1 拆模型位:不要指望一个模型全包
选型文档的第一件事,是把流水线拆成 6 个"模型位"(对应 2.1 节链路图的各个环节):
| 模型位 | 任务 | 关键要求 | 类型 |
|---|---|---|---|
| ① 感知 VLM | 读商品图 → 结构化 JSON | 读图准、JSON 稳、便宜(高频) | 多模态 |
| ② Agent 大脑 | 推理规划:选管线、定张数、排模块 | 指令遵循、结构化输出 | 文本 LLM |
| ③ 文案 | 卖点文案、参数介绍 | 中文电商语感、性价比 | 文本 LLM |
| ④ 抠图 | 提取透明产品 PNG | 边缘精细度 | 视觉模型 |
| ⑤ 视觉重建 | 深度图、法线图 | 几何准确性 | 视觉模型 |
| ⑥ 图像生成 | 统一光影出图(成本大头) | 光影真实感、商品一致性 | 生成模型 |
拆完位,结论自然浮出水面:这 6 个位对模型的要求完全不同,必须多模型分层路由——这是 2026 年 Agent 工程的第一共识。感知位要"便宜大碗"(单次读图不到 1 分钱),大脑位要"指令遵循和 JSON 稳定性",出图位要"商品一致性"。用一个旗舰模型全包?钱包先死。
4.2 一次真实的"盲测反转":价格不是选型的唯一标准
这是整个选型阶段最值钱的一课。
初版选型,出图位主推 GLM-Image:0.1 元/张,MIT 开源,指令遵循和文字渲染突出,账面成本碾压 Seedream 4.5(0.25 元/张)。文档里连降级顺位都排好了。
结果用真实商品(折叠手机支架)盲测,结论当场反转:
Seedream 4.5 商品一致性接近完美——铰链、折叠臂、挂钩、底座全保留,甚至延续原图场景;GLM-Image 是"同类不同款"的重绘。
对电商详情页这个场景,商品一致性是生死线:支架的铰链结构变了,消费者收到货和详情页两回事,这是假图,是平台合规红线。0.15 元/张的差价,在"能不能用"面前不值一提。选型文档随即修订:Seedream 4.5 升为主选,GLM-Image 降为低成本备选。
这个案例的方法论价值:选型文档不是调研报告,是待验证的假设清单。每个"主推"都要标注验证方式和验证成本。盲测三个候选,成本是几十块钱加半天——这点成本在"上线后返工"面前等于零。AI 时代试错变便宜了,"先实测再拍板"从奢侈品变成了基本操作。
4.3 成本测算:先算账,再动手
选型文档按最终组合重算了单套成本(10 张图口径):
| 环节 | 成本 |
|---|---|
| 感知(GLM-4.6V,~5K in / 1K out) | ~0.01 元 |
| 大脑规划(DeepSeek Flash) | ~0.05 元 |
| 文案(同上) | ~0.05 元 |
| 出图 10 张(GLM-Image @0.1) | 1.0 元 |
| 自检(GLM-4.6V) | ~0.02 元 |
| 合计(GLM-Image 低成本方案) | ≈ 1.1 元/套 |
(盲测反转后若全程用 Seedream 4.5 主选出图,单套约 2.6 元;产品定价按 2-8 元/套的 API 成本核算,空间立得住。)
两个关键认知:
- LLM 环节合计不到 1 毛钱,可以随便用;成本几乎全在出图(占 95% 以上)——所以优化成本要盯着出图位打,在感知/文案上抠性价比是捡芝麻;
- 成本结构决定商业模式:单套 1-3 元的边际成本,让"BYOK + 成本透明展示"成立——我们敢把每个任务的消耗金额明示给用户看,就是因为算得过这笔账。
4.4 一个坑位预警:模型能力边界要写进落地清单
选型文档专门记了落地注意点,其中一条救了后面无数时间:
DeepSeek V4.1-Flash 是纯文本模型——读图和自检全部走 GLM-4.6V,大脑只消费结构化 JSON 文本,编排层注意不要给 DeepSeek 传图。
这类"能力边界 + 编排纪律",在选型阶段写下来,实现阶段就是 checklist;不写,就是某个深夜的一次玄学 bug。
五、第三步:决策留痕,用 ADR 把"为什么"钉住
代码回答"怎么做",文档回答"为什么"。大多数项目只记前者,于是三个月后的重构会议上,大家对着一段"看不懂但不敢删"的代码面面相觑。
我们的做法:关键决策一人一篇 ADR(架构决策记录),固定三段式:背景 → 决策 → 后果。
以 ADR-0007 为例,它在解决一个真实的两难:
- 上一轮刚把"商品类目"(如"羽绒服""零食")升级为可配置实体,但类目的备注里反复写着"尺码表/配料/资质数据必须来自用户输入"——羽绒服的面料成分、零食的保质期,AI 从商品图里根本看不出来,只能编;而编造参数在电商场景是假图红线。可系统里当时根本没有"用户结构化输入"的通道,参数全靠 AI 猜;
- 同时卡片视觉模板系统已跑起来,但没有任何东西替不同品类"选一个合适的默认模板"。
决策部分干净利落:纳入 A(结构化参数表单)/ C(类目默认模板)/ D(生成默认开关)三个方向,B(合规红线结构化校验)明确不做,留待后续。
而全文最值得学的是**"后果"一节——主动写下代价和要守住的东西**:
- 人像硬约束引入"敏感类目"标志(如内衣/泳装强制关闭人像场景),必须用显式 id 集合判定,不得依赖关键词模糊匹配(安全项要确定性);
- C 让全局默认从"最终决定"退为"兜底",设置页文案必须说清,避免用户困惑"我设的没生效";
- 优先级链统一遵循:显式用户选择 > 类目默认 > 全局/AI 兜底。
一段决策,附带三条"未来可能踩的坑"和一条统一的优先级哲学。后来者(包括三个月后的你自己)读到这篇,五分钟后就能获得作者当时三天的上下文。
ADR 的写作要领:决策部分可以很短,但"后果 + 代价"不能省。 只写"我们决定用 X"的 ADR 是半成品;写出"选了 X,我们付出了 Y,未来要守住 Z"才是完整品。
六、第四步:需求到任务的"翻译层"——OpenSpec 规格治理
PRD 说的是"产品要什么",ADR 说的是"为什么这么设计",还差一层:这个变更具体改哪些文件、动哪些能力、怎么验收。这一层我们交给 OpenSpec 管,流程是 proposal → design → specs → tasks,落地后归档留痕。
看一个真实提案的骨架——"首次启动配置向导"(BYOK 产品的第一道门槛:新用户打开应用后,四步引导配好模型密钥,否则连工作台都进不去):
Why:首次使用门槛是最大流失点——用户要自己判断四把 key 哪两把必需、找到设置页、逐张展开指引,配完面对空工作台。
What Changes:五条变更,每条一句话,包括"首次启动以本地不存在配置文件为唯一信号""隐私承诺前移到任何真实调用与扣费之前"。
Capabilities:新建 / 修改哪些能力规格。
Impact:落到文件级——
internal/config/config.go:新增OnboardingDone/OnboardingSkipped持久化字段;app.go+frontend/wailsjs/:新增绑定方法,需重新生成;frontend/src/components/OnboardingWizard.vue(新):四步覆层;- 零新依赖(
deps.yaml不动);样式一律走既有设计 tokens。
为什么 Impact 要写到文件名?这是 AI 时代的新变化:文档的第一读者已经从人变成了 AI 编码 agent。agent 没有你大脑里的项目上下文,"改 onboarding.go、在 App.vue 加引导闸门、复用 ProviderGuidePanel.vue"这种粒度,恰好是 agent 能直接执行、人也能 review 的甜点。写得粗("做个向导"),agent 自由发挥,产出随机;写得细(到文件和复用组件),产出稳定。
顺带说 Capabilities 的规格库:项目把能力按域维护在 openspec/specs/ 下(onboarding-wizard、architecture-guardrails、dependency-registry 等二十多个),新变更提案必须声明新建/修改哪些能力——这和上一篇的护栏是同一套哲学:约定要变成可校验的结构,而不是散落的散文。
七、第五步:实施用"问题定位表"驱动,而不是感觉驱动
到了写代码阶段,最常见的失败模式是"重构一时爽,改完到处火"。我们的做法来自一份真实优化方案:初版流水线跑通后,产出的详情页"效果一般",这份方案的任务就是定位"一般在哪"——它的核心是一张问题定位表:
| # | 病灶 | 代码位置 | 后果 |
|---|---|---|---|
| 1 | 感知仅 7 字段,无细节特征、无可见参数 | internal/agent/agent.go:72-73 | 下游规划/渲染/文案全部泛化;参数表无数据源只能编造 |
| 2 | 规划是"伪规划":模块固定 5 个写死、prompt ≤60 字 | agent.go:93-95 | 出图缺乏摄影语义;模块结构千篇一律 |
| 3 | 自检是"盲检":只传生成图,不给原图与场景描述 | agent.go:161-167、pipeline.go:421-425 | 自检形同虚设;同参数重跑无意义 |
| 4 | 文案模型看不到图,输入只有 7 字段 | agent.go:140-149 | 套话文案,图文不对齐 |
三个设计要点:
第一,病灶必须锚定到代码行号。 "效果一般"不是问题,"agent.go:93-95 模块写死"才是问题。前者只能开会,后者可以直接改。这一条是 AI 编码时代的放大器:你把带行号的问题表丢给 AI,它改得比谁都准;只丢一句"优化下效果",它只能瞎猜。
第二,优先搬"已验证的设计",别发明轮子。 方案里专门列了姊妹项目(同脚手架的闲鱼素材生成器)的借鉴清单:粘贴电商详情作为核心输入(≤4000 字)、按角色差异化文案 + 跨卡不重复铁律、图片完整显示不裁切(原话:"卖货最忌讳图切没了")——每条都标注了"已验证结论"再落入本期方案。别的项目踩过的坑,是你最便宜的选型依据。
第三,P0-P2 分级 + 设计原则前置。 方案开头五条设计原则:"商品像素尽量不过生成器""prompt 分层""编造即违规:参数/资质类信息只允许来自图中可见转写或用户输入,缺失就降级占位"——原则是排序工具,P0/P1 打架时按原则裁断。其中"编造即违规"直接对着电商假图红线:参数卡的数据源只有两个——图中转写,或用户输入,AI 猜的不算数。
八、第六步:实测数据回写文档,形成闭环
这是整套方法论里最容易被跳过、但 ROI 最高的一步。看 PRD v1.3 的真实联调记录(节选):
M1/M2 开发完成并真实 key 全流程联调通过:三把密钥连通(GLM-4.6V 需关思考模式,640ms);GLM-Image 图生图参数形状实测可用;新账户 glm-image 限流严格,渲染并发降为 1 + 指数退避重试(10/20/40/60s);单套(5 图)实测 8 分 27 秒,符合 ≤10 分钟目标。
一段话,四类信息:
- 踩坑:GLM-4.6V 要关思考模式——不记下来,下次配环境再踩一遍;
- 约束:新账户限流(RPM)严格,出图并发一高就撞 429——所以渲染并发从设计值降为 1(一张一张来),退避序列定为 10/20/40/60 秒。这个约束后来直接影响了批量调度的并发上限设计(默认 1、可配 1-3);
- 验收:8 分 27 秒 vs ≤10 分钟目标——价值主张"约 10 分钟得到整套详情页"从此是实测背书,不是营销话术;
- 修订:渲染并发、重试策略、批量并发默认值,全部因为这段实测回写而改变。
文档的尊严是这么来的:它的每个数字都有人在现场为其负责。 反观大多数项目,PRD 里的"支持高并发"直到上线都没人验证过。
九、第七步:质量兜底——把"稳定性"当需求做
AI 应用和传统软件还有个区别:你的依赖是概率性的。同一个 prompt,这次返回合法 JSON,下次裹一层 markdown 围栏;这次商品一致,下次铰链漂移。所以"质量控制"不是测试阶段的事,是架构阶段的事。我们把四道闸做进了流水线:
- 结构化输出校验:所有模型输出强制 JSON,解析前剥围栏;字段级容错(模型输出
key/label都能认);失败自动重试——选型文档原话:"这是 Agent 稳定性的第一道闸"。 - 自检门限:自检环节双图对比(原图 vs 生成图),商品保持度 fidelity < 0.95 直接 fail(对齐 OpenAI Image Evals 门限),不通过自动重渲染,且诊断 tags 回灌下一次重试——"同参数重跑无意义"是业内用教训换来的结论。
- 编造拦截:前面说的"参数只来自图中转写或用户输入",落到代码就是 KV 权威合并规则:用户填的 > AI 猜的,AI 只补空。
- 架构护栏:约定即测试——app.go 不许 import gorm、新模型必须登记 AllModels、新增依赖必须登记 deps.yaml。上一篇专门讲过,不展开。
四道闸的共同哲学:概率性依赖,要用确定性工程兜底。
十、总结:一条可复制的落地路径
整个路径画出来是这样:
图 5:七步路径。①-④ 是规划期,想清楚再动手;⑤-⑦ 是执行期,用确定性工程兜住概率性依赖;红色回环是这套方法的心脏——实测结论回头修订文档。
把整个实战过程压缩成一张表:
| 阶段 | 产出物 | 核心动作 |
|---|---|---|
| ① 需求 | 活 PRD(带修订记录) | 拍板问题清单;用户故事三段式;明确不做清单 |
| ② 选型 | 选型对比 + 假设清单 | 拆模型位;多模型分层路由;盲测验证后再定主推;成本测算 |
| ③ 决策 | ADR | 背景/决策/后果三段式;后果里写代价和要守住的线 |
| ④ 翻译 | 变更提案(Impact 到文件级) | 能力规格声明;零新增依赖声明;写给 AI agent 也能执行的粒度 |
| ⑤ 实施 | 问题定位表 + 分级方案 | 病灶锚定代码行号;搬已验证设计;P0-P2 + 设计原则 |
| ⑥ 验收 | 实测数据回写 | 联调记录进 PRD 版本;踩坑/约束/验收三类信息 |
| ⑦ 兜底 | 四道闸 | 结构化校验;自检门限 + tags 回灌;编造拦截;架构护栏 |
最后说三条 AI 时代特有的体会,也是这篇最想传递的东西:
- 文档的读者变了。 以前文档写给人看,现在第一读者是 AI 编码 agent——Impact 要写到文件名,约定要变成护栏断言,问题要锚定到代码行号。文档质量的下限,就是 AI 产出的上限。
- 试错变便宜了,"先验证再拍板"从美德变成了本分。 盲测三个模型几十块钱,联调一次半天。因为便宜,所以必须做——省下的小钱,都会在上线后变成大坑。
- 代码是最便宜的部分,"想清楚"最贵。 这个项目真正的资产不是那几万行 Go 和 Vue,是那份被实测反复修订过、每个数字都有人负责的文档体系。它保证了:三个月后的任何人(和任何 AI)接手这个项目,都能在半小时内获得作者当时三天的上下文。
需求落地没有银弹,但这条"文档驱动 + 实测修订"的路径,是我们用一个月真实项目从构想到跑通验证过的实战。坑都替你们踩完了。
如果这篇对你有启发,点赞收藏关注三连。下一篇进硬货:多模型 Agent 流水线实战——四家服务商、六个模型位,"读图 → 规划 → 出图 → 文案 → 排版 → 自检"怎么用 Go 串成全自动闭环,单套 8 分半背后的调度、降级与重试设计。
作者按:文中所有版本记录、盲测结论、联调数据均取自生产仓库 docs/ 目录实录,未做演绎。